
|
210| 0
|
零基础实操把知识库接到聆思CSK6大模型开发板上 |
《《《 点击这里展开全文 》》》 | ||


关于社区|统计|联系我们|隐私条款|免责声明|网站地图|小黑屋|帮助中心|清除cookies
Copyright ©2011-2024 NTpcb.com All Right Reserved. Powered by Discuz! (NTpcb)
本站信息均由会员发表,不代表NTpcb立场,如侵犯了您的权利请举报投诉
本站所有资料仅限参考学习交流,PCB原理图源码等所有资料不保证准确没问题,请不要用作生产。否则后果自负。
 闽公网安备35062302000276号 | 闽ICP备2024076463号-1 | 论坛技术支持QQ群171867948 | 论坛问题,充值问题请联系QQ1308068381


 再发某公司的PADS格式 PCB封装库全套共享
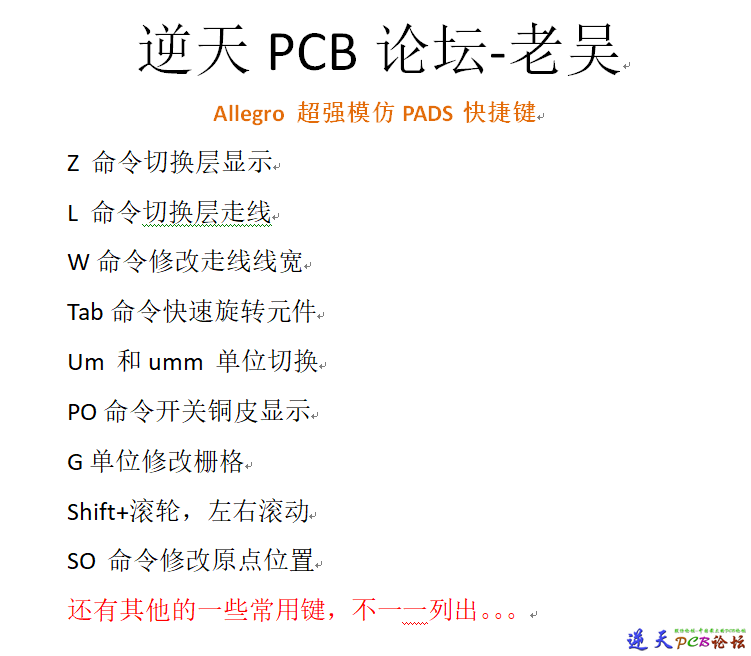 Allegro超强最全模仿PADS快捷键实现Z切换层
 STM32F412RET6+HT97220+NS4158+RDA5807M 做
 STM32F412RGT6 做的MP3播放器PCB文件和原理
 博通BK7238LP低电压版本 WIFI 蓝牙双模芯片
 博通BK7238 WIFI 蓝牙双模芯片PCB和原理图
 博通BK7238 WIFI 蓝牙双模芯片PCB和原理图
 allegro羊皮卷
 【AI选型】AI做元器件选型,速度快十倍
 AB5327C SOP16_带MIC蓝牙音箱原理图和datas
 GB 4943.1-2022标准全文高清.pdf
 C3294371_线对板针座_HC-MX3.0-2-2A_规格书
 Altium designer 元件库大全(终结版)
 C7541613_线对板针座_ZX-MX3.0-2-2PZZ_规格
 STM32 做的MINI机器人PCB和原理图
 配套STM32H7核心板的主板
 基于XCZU27DR设计的18层射频采集与处理板卡
 JC-AGL-萃茶机升级版 控制板PCB文件
 SSD SM2246EN 2.5英寸SSD的PCB原理图
 STM32F103C8T6 做的DST手柄遥控器PCB文件共享
 Infinity 大功率三相无刷电调无刷电机驱动器PCB原理图


 发表于 2025-5-23 16:02


 提升卡
 置顶卡
 变色卡(高亮)
 千斤顶
 照妖镜